
meta charset utf-8: ошибки 404 из-за корейских адресов изображений, сломанных краулером AdSense, и переполненный php-fpm
Если читающая сторона не находит объявление meta charset utf-8 в начале HTML, а в заголовке ответа тоже нет charset, ей приходится угадывать кодировку символов документа или читать его со значением по умолчанию. На сервере WordPress со связкой Nginx и Apache краулер AdSense массово отправил запросы к сломанным корейским (не-ASCII) адресам изображений, и обработка 404 заняла все воркеры PHP. После разбора логов в заголовок ответа кешированных страниц добавлен charset, а nginx теперь сразу отвечает 404 на несуществующие статические файлы, поэтому те же запросы больше не забивают воркеры.
1️⃣ meta charset utf-8: почему он должен быть в первых 1024 байтах
Сервер может сообщить кодировку символов документа в двух местах: в charset после заголовка ответа [Content-Type] и в строке meta charset внутри HTML.
Стандарт HTML требует, чтобы объявление кодировки находилось только в первых 1024 байтах, и советует читающей стороне заранее читать только эти первые 1024 байта, чтобы его найти. Поэтому даже внутри head meta charset, сдвинутый за 1024 байта, некоторые читающие стороны не находят.
Чтобы выбрать кодировку, читающая сторона сначала смотрит на BOM (метку порядка байтов), затем на charset в заголовке ответа, а потом на meta charset, найденный при предварительном чтении первых 1024 байтов. Если нет ни одного из трёх, она угадывает по виду байтов или берёт заданное значение по умолчанию, а в таблице значений по умолчанию, которую предлагает стандарт HTML, для большинства locale это windows-1252.
Если прочитать документ в UTF-8 как windows-1252, один символ из нескольких байтов, например корейская буква, превращается в несколько других символов.
2️⃣ Корейские (не-ASCII) адреса изображений, которые сломал краулер AdSense Mediapartners-Google
Проверка кешированной страницы до исправления по критерию первых 1024 байтов показала: в заголовке ответа Content-Type не было charset, а строка meta charset стояла на 15 199-м байте. То есть в кешированной странице, которую получил краулер AdSense Mediapartners-Google, кодировку нельзя было найти ни в одном из двух мест.
curl -sI https://example.com/sample-post/ | grep -i '^content-type'content-type: text/htmlВ этой связке, если добавить к адресу строку запроса, кешированная страница пропускается и приходит ответ, который PHP сформировал напрямую, и в этом ответе charset был.
curl -sI 'https://example.com/sample-post/?nocache=1' | grep -i '^content-type'content-type: text/html; charset=UTF-8С какого байта в файле кеша начинается meta charset, можно проверить с точностью до байта через [grep -b].
grep -bo '<meta charset' /var/www/html/wp-content/cache/wp-rocket/example.com/sample-post/index-https.html | head -115199:<meta charsetВ тегах img того же файла кеша многоязычные имена файлов в UTF-8 (в данном случае корейские) стояли как есть, без процентного кодирования. Если прочитать этот HTML как windows-1252, имя вроде [대시보드-화면-예시.png] превращается в символы вроде [대시보드-화면-예시.png], а если эти символы снова закодировать в процентах как UTF-8 и запросить, сервер ищет файл, которого нет.
Если выбрать из журнала доступа ошибки 404 изображений, которые получил этот краулер, адреса со сломанными именами идут один за другим.
grep 'Mediapartners-Google' /var/log/nginx/access.log | grep ' 404 ' | grep 'GET /wp-content/uploads/' | cut -d' ' -f1,4,7,9 | head -2203.0.113.3 [03/Nov/2026:20:40:51 /wp-content/uploads/2025/07/---1024x682.png 404
203.0.113.1 [03/Nov/2026:20:40:51 /wp-content/uploads/2025/07/---300x159.jpg 404Адреса в журнале побайтно совпадали со значением, которое получается, если прочитать UTF-8-байты исходного имени файла как символы windows-1252 и снова закодировать в UTF-8. В журнале за тот день запросов к так же сломанным адресам изображений было 202 от этого краулера и 6 от одного скрипта (python-requests), а от посетителей — 0.
Если пропустить сломанное имя [대시보드-화면-예시.png] через инструмент Конвертер UTF-8, оно определяется как UTF-8-байты, прочитанные как windows-1252, и появляется исходное имя [대시보드-화면-예시.png].
3️⃣ Как ошибки 404 несуществующих изображений заполнили php-fpm
Поскольку изображений по сломанным адресам на сервере нет, nginx по последнему пункту try_files в своём правиле location для изображений передал запросы в Apache, а WordPress сформировал страницу 404 через PHP. Среди 587 ошибок 404, записанных днём в тот же день, каждая страница 404 без кеша занимала в медиане 1,4 секунды.
Запросы изображений со сломанными именами накопились до чуть более 200 за 3 минуты начиная с 20:40, и 133 из них закончились ошибкой 404. Каждому запросу выделяется один воркер php-fpm, и поскольку запросы продолжали поступать, пока каждая ошибка 404 занимала от 4 до 6 секунд, пул упёрся в предел в 20:40:55.
Момент, когда пул упирается в предел, остаётся в журнале ошибок php-fpm: Предупреждение php-fpm max_children.
grep 'max_children' /var/log/php-fpm/error.log[03-Nov-2026 20:40:55] WARNING: [pool www] server reached pm.max_children setting (20), consider raising itЗапросы, пришедшие после заполнения пула, ждали свободного воркера. Дольше всех ждавшая ошибка 404 завершилась через 58 секунд, запросы, которые краулер оборвал после 60 секунд ожидания, записаны как 499, а один запрос, не получивший ответа от бэкенда, — как 504.
Предзагрузку кеша, запланированные задачи (Action Scheduler), работавшие в то же время, и wp-cron, запускаемый каждую минуту, были проверены и исключены из причин. Предзагрузка весь день шла с одной и той же низкой скоростью, запланированные задачи в это время обрабатывали только задания предзагрузки, а wp-cron запускается через PHP из командной строки и не использует воркеры php-fpm.
4️⃣ nginx charset utf-8 и сразу 404 для несуществующих статических файлов
В location nginx, которая отдаёт кешированные страницы, добавлена одна строка [charset utf-8;], чтобы в заголовке ответа был charset, а для изображений и статических файлов в папке загрузок nginx теперь сразу возвращает 404, если их нет на диске, вместо передачи в WordPress.
# Блок http: значение Cache-Control задаётся только для ответов 404
map $status $up404_cc { 404 'no-store'; default ''; }

# location, которая сразу отдаёт кешированный HTML
location / {
    try_files $cache_file @backend;
    charset utf-8;
}

# Папка загрузок: несуществующие изображения сразу получают 404 без передачи в бэкенд
location ~* ^/wp-content/uploads/.+[.](jpg|jpeg|png)$ {
    try_files $uri =404;
    add_header Cache-Control $up404_cc always;
}
map размещается в блоке http, а поскольку nginx не отправляет заголовок с пустой строкой в значении, ответы 200 не получают no-store. location с регулярными выражениями применяются сверху вниз, и срабатывает первая подходящая, поэтому она стоит перед существующей location изображений, а для статических файлов вроде css, js и шрифтов добавлена ещё одна location того же вида.
После исправления повторный запрос того же адреса показал, что в заголовке ответа кешированной страницы появился charset.
curl -sI https://example.com/sample-post/ | grep -i '^content-type'content-type: text/html; charset=utf-8curl -sI https://example.com/wp-content/uploads/2025/07/no-such-image.png | grep -i -E '^(HTTP|content-type|cache-control)'# До исправления: 404, сформированная WordPress
HTTP/2 404
content-type: text/html; charset=UTF-8
cache-control: no-cache, must-revalidate, max-age=0, no-store, private
# После исправления: 404, которую nginx вернул сразу
HTTP/2 404
content-type: text/html
cache-control: no-storeОшибка 404 для несуществующего изображения сменилась со страницы WordPress, которая формировала 319 058 байт за 1,01 секунды, на стандартную страницу nginx, которая возвращается за 0,015 секунды и весит 555 байт. Поскольку [Cache-Control: no-store] добавляется только к 404, CDN не сохраняет ошибки 404 несуществующих изображений. К ответам, которые PHP уже отправил с charset, nginx не добавляет charset повторно, поэтому в заголовке ответа он появился только один раз.
| Проверенный запрос | До исправления | После исправления |
|---|---|---|
| Несуществующее изображение | 319 058 B, 1,01 секунды (404 WordPress) | 555 B, 0,015 секунды (404 nginx) |
| Изображение со сломанным именем | 1,05 секунды (404 WordPress) | 0,014 секунды (404 nginx) |
| Заголовок ответа кешированного HTML | text/html | text/html; charset=utf-8 |
| Заголовок ответа, сформированный PHP напрямую | text/html; charset=UTF-8 | Так же (charset один раз) |
| Существующее изображение | 200 | По-прежнему 200 |
Такая обработка 404 не подходит сайтам с плагинами изображений, которые создают миниатюры или WebP через PHP уже после поступления запроса. Поскольку nginx первым возвращает 404, изображение так и не создаётся. Если ваша конфигурация заранее создаёт файлы WebP при загрузке, её можно применить как есть.
5️⃣ Почему meta charset сдвинулся назад: WP Rocket Delay JS
Даже после добавления charset в заголовок ответа meta charset в кешированном HTML по-прежнему стоит на 15 199-м байте. На странице, которую PHP формирует напрямую, та же строка стояла на 135-м байте.
Если в WP Rocket включён Delay JS, при создании файла кеша сразу после head вставляются скрипты отложенного выполнения вроде lazyload, а затем отдельный шаг возвращает meta charset в самое начало head. Этот шаг применяет регулярное выражение ко всему документу, поэтому на большой записи размером около 1,2 МБ он превышает предел backtrack в PHP и завершается неудачей.
Когда регулярное выражение не срабатывает, WP Rocket кеширует HTML как есть — со вставленными скриптами, но без перенесённого meta charset, — и в результате meta charset оказался за пределами первых 1024 байтов. В отдельном воспроизведении с теми же настройками PHP перенос не удался при пределе backtrack по умолчанию 1 000 000 и при 5 000 000 и удался начиная с 10 000 000.
На этот раз задача решена добавлением charset в заголовок ответа, а положение meta charset не исправлялось. Повышение предела backtrack возвращает исходное поведение WP Rocket, но увеличивает в 10 раз предел для всех регулярных выражений в том же PHP, поэтому этот путь не рекомендуется.
🔢 FAQ & рекомендуемые материалы

 HTTP 404
Ошибка HTTP 404 (ошибка клиента): причины и решение
Страница ошибки HTTP 404, одного из кодов состояния HTTP, появляется, когда страницу не удаётся найти.
 AdSense
Настройка ads.txt в WordPress: как устранить предупреждение AdSense
ads.txt — это текстовый файл в корне сайта, который публично перечисляет авторизованных продавцов, имеющих право продавать рекламные места этого домена.
 Кеш WP Rocket
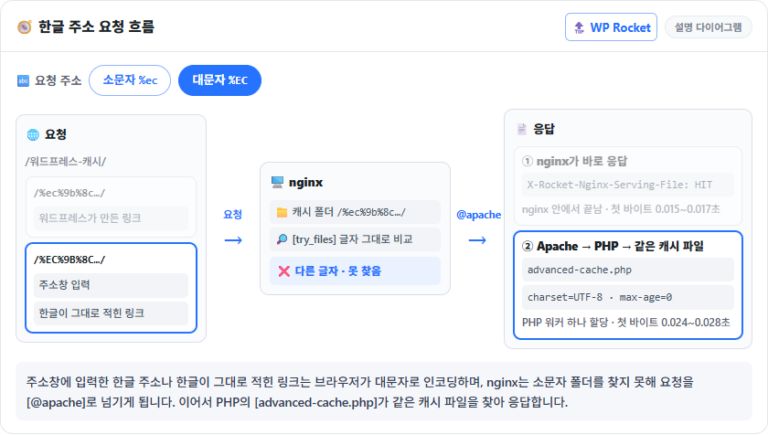
WP Rocket и корейские URL: почему nginx не находит файл кеша и решение через njs
Для записей с английским слагом nginx сразу отдаёт файл кеша, а для записей с корейским слагом тот же файл кеша отдаётся только после того, как PHP один раз отработает, даже если файл уже существует.
ℹ️ О партнёрских ссылках
Материалы этого сайта содержат партнёрские ссылки. Если посетитель покупает товар или услугу по такой ссылке, сайт получает комиссию от продавца. При этом сумма, которую платит покупатель (при акционных скидках сумма снижается ↓), не увеличивается. Указанные цены, скидки и наличие актуальны на момент написания и могут отличаться, поэтому перед покупкой уточняйте их у продавца. Товары выбираются и оцениваются по нашим собственным критериям, а комиссия не влияет ни на порядок, ни на содержание обзоров.