
meta charset utf-8: 404 da indirizzi di immagini in coreano rotti dal crawler di AdSense e php-fpm pieno
Se il lettore non trova la dichiarazione meta charset utf-8 all'inizio dell'HTML e anche l'intestazione di risposta non ha charset, deve indovinare la codifica dei caratteri del documento o leggerlo con un valore predefinito. Su un server WordPress con Nginx e Apache, il crawler di AdSense ha inviato una raffica di richieste verso indirizzi di immagini in coreano (non ASCII) rotti, e la gestione dei 404 ha occupato tutti i worker PHP. Dopo averlo seguito nei log, ho aggiunto charset all'intestazione di risposta delle pagine in cache e ho fatto rispondere nginx direttamente con un 404 ai file statici inesistenti, così le stesse richieste non riempiono più i worker.
1️⃣ meta charset utf-8: perché deve stare nei primi 1.024 byte
Il server può indicare la codifica dei caratteri del documento in due punti: il charset aggiunto dopo l'intestazione di risposta [Content-Type] e la riga meta charset scritta dentro l'HTML.
Lo standard HTML stabilisce che la dichiarazione della codifica compaia solo nei primi 1.024 byte, e consiglia al lettore di leggere in anticipo solo quei primi 1.024 byte per trovarla. Per questo, anche dentro head, un meta charset spinto oltre 1.024 byte può sfuggire ad alcuni lettori.
Per decidere la codifica, il lettore guarda prima il BOM (byte order mark), poi il charset dell'intestazione di risposta e infine il meta charset trovato con la lettura preliminare dei primi 1.024 byte. Se non c'è nessuno dei tre, ipotizza in base alla forma dei byte o usa un valore predefinito, e nella tabella dei valori predefiniti proposta dallo standard HTML la maggior parte dei locale ha windows-1252.
Se leggi un documento UTF-8 come windows-1252, un singolo carattere di più byte, come una lettera coreana, diventa diversi caratteri differenti.
2️⃣ Indirizzi di immagini in coreano (non ASCII) rotti dal crawler di AdSense Mediapartners-Google
Controllando la pagina in cache di prima della correzione con il criterio dei primi 1.024 byte, l'intestazione di risposta Content-Type non aveva charset e la riga meta charset si trovava al byte 15.199. Quindi la pagina in cache ricevuta dal crawler di AdSense Mediapartners-Google non aveva una codifica rintracciabile in nessuno dei due punti.
curl -sI https://example.com/sample-post/ | grep -i '^content-type'content-type: text/htmlIn questa configurazione, se aggiungi una query string all'indirizzo, la pagina in cache viene saltata e arriva una risposta generata direttamente da PHP, e quella risposta aveva il charset.
curl -sI 'https://example.com/sample-post/?nocache=1' | grep -i '^content-type'content-type: text/html; charset=UTF-8Con [grep -b] vedi, byte per byte, in quale posizione del file di cache inizia il meta charset.
grep -bo '<meta charset' /var/www/html/wp-content/cache/wp-rocket/example.com/sample-post/index-https.html | head -115199:<meta charsetI tag img dello stesso file di cache contenevano nomi di file multilingue in UTF-8 (qui in coreano) così com'erano, senza codifica percentuale. Se questo HTML viene letto come windows-1252, un nome come [대시보드-화면-예시.png] diventa caratteri come [대시보드-화면-예시.png], e se quei caratteri vengono di nuovo codificati in percentuale come UTF-8 e richiesti, il server cerca un file che non esiste.
Se estrai dal log di accesso i 404 delle immagini ricevuti da questo crawler, compaiono uno dopo l'altro indirizzi con nomi rotti.
grep 'Mediapartners-Google' /var/log/nginx/access.log | grep ' 404 ' | grep 'GET /wp-content/uploads/' | cut -d' ' -f1,4,7,9 | head -2203.0.113.3 [03/Nov/2026:20:40:51 /wp-content/uploads/2025/07/---1024x682.png 404
203.0.113.1 [03/Nov/2026:20:40:51 /wp-content/uploads/2025/07/---300x159.jpg 404Gli indirizzi rimasti nel log erano identici, byte per byte, al valore ottenuto leggendo i byte UTF-8 del nome originale come caratteri windows-1252 e codificandoli di nuovo in UTF-8. Nel log di quel giorno le richieste a indirizzi di immagini rotti nello stesso modo erano 202 da questo crawler e 6 da un singolo script (python-requests), e 0 dai visitatori.
Se passi il nome rotto [대시보드-화면-예시.png] con lo strumento Convertitore UTF-8, viene riconosciuto come byte UTF-8 letti come windows-1252 e ricompare il nome originale [대시보드-화면-예시.png].
3️⃣ Come i 404 delle immagini inesistenti hanno riempito php-fpm
Poiché le immagini degli indirizzi rotti non esistono sul server, nginx ha passato le richieste ad Apache seguendo l'ultima voce di try_files nella sua regola location per le immagini, e WordPress ha generato la pagina 404 con PHP. Guardando i 587 404 registrati di giorno in quella stessa data, ogni pagina 404 senza cache ha richiesto una mediana di 1,4 secondi.
Le richieste di immagini con nomi rotti si sono accumulate fino a poco più di 200 nei 3 minuti dalle 20:40, e 133 di esse sono finite con un 404. Ogni richiesta riceve un worker di php-fpm, e poiché le richieste continuavano ad arrivare mentre ogni 404 richiedeva da 4 a 6 secondi, il pool ha raggiunto il limite alle 20:40:55.
Il momento in cui il pool raggiunge il limite resta nel log degli errori di php-fpm: Avviso php-fpm max_children.
grep 'max_children' /var/log/php-fpm/error.log[03-Nov-2026 20:40:55] WARNING: [pool www] server reached pm.max_children setting (20), consider raising itLe richieste arrivate dopo il riempimento del pool hanno aspettato un worker libero. Il 404 che ha aspettato di più è finito dopo 58 secondi, le richieste che il crawler ha interrotto dopo 60 secondi di attesa sono state registrate come 499, e una richiesta rimasta senza risposta dal backend come 504.
Il precaricamento della cache, le attività pianificate (Action Scheduler) in esecuzione alla stessa ora e wp-cron, eseguito ogni minuto, sono stati controllati ed esclusi come causa. Il precaricamento girava tutto il giorno alla stessa velocità bassa, le attività pianificate a quell'ora elaboravano solo lavori di precaricamento, e wp-cron viene eseguito con PHP da riga di comando e non usa i worker di php-fpm.
4️⃣ nginx charset utf-8 e 404 immediato per i file statici inesistenti
Ho aggiunto la riga [charset utf-8;] alla location di nginx che serve le pagine in cache, così l'intestazione di risposta ha il charset, e per le immagini e i file statici della cartella degli upload, se non sono su disco, ora nginx restituisce direttamente un 404 invece di passarli a WordPress.
# Blocco http: imposta un valore Cache-Control solo per le risposte 404
map $status $up404_cc { 404 'no-store'; default ''; }

# location che serve direttamente l'HTML in cache
location / {
    try_files $cache_file @backend;
    charset utf-8;
}

# Cartella degli upload: le immagini inesistenti ricevono subito un 404 senza passare dal backend
location ~* ^/wp-content/uploads/.+[.](jpg|jpeg|png)$ {
    try_files $uri =404;
    add_header Cache-Control $up404_cc always;
}
La map va nel blocco http, e poiché nginx non invia un'intestazione il cui valore è una stringa vuota, le risposte 200 non ricevono no-store. Le location con espressione regolare si applicano dall'alto e vale la prima che corrisponde, quindi l'ho messa prima della location delle immagini esistente e ho aggiunto un'altra location dello stesso tipo per i file statici come css, js e font.
Richiedendo di nuovo lo stesso indirizzo dopo la correzione, l'intestazione di risposta della pagina in cache aveva il charset.
curl -sI https://example.com/sample-post/ | grep -i '^content-type'content-type: text/html; charset=utf-8curl -sI https://example.com/wp-content/uploads/2025/07/no-such-image.png | grep -i -E '^(HTTP|content-type|cache-control)'# Prima della correzione: un 404 generato da WordPress
HTTP/2 404
content-type: text/html; charset=UTF-8
cache-control: no-cache, must-revalidate, max-age=0, no-store, private
# Dopo la correzione: un 404 restituito direttamente da nginx
HTTP/2 404
content-type: text/html
cache-control: no-storeIl 404 di un'immagine inesistente è passato da una pagina di WordPress che generava 319.058 byte in 1,01 secondi alla pagina predefinita di nginx, restituita in 0,015 secondi con 555 byte. Aggiungendo [Cache-Control: no-store] solo ai 404, la CDN non salva i 404 delle immagini inesistenti. nginx non aggiunge di nuovo charset alle risposte che PHP ha già inviato con il charset, quindi è comparso una sola volta nell'intestazione di risposta.
| Richiesta controllata | Prima della correzione | Dopo la correzione |
|---|---|---|
| Immagine inesistente | 319.058 B, 1,01 secondi (404 di WordPress) | 555 B, 0,015 secondi (404 di nginx) |
| Immagine con nome rotto | 1,05 secondi (404 di WordPress) | 0,014 secondi (404 di nginx) |
| Intestazione di risposta dell'HTML in cache | text/html | text/html; charset=utf-8 |
| Intestazione di risposta generata direttamente da PHP | text/html; charset=UTF-8 | Uguale (charset una volta) |
| Immagine esistente | 200 | Resta 200 |
Questa gestione dei 404 non va bene per i siti con plugin per immagini che generano miniature o WebP con PHP dopo l'arrivo di una richiesta. Poiché nginx restituisce prima il 404, l'immagine non viene mai generata. Se la tua configurazione crea in anticipo i file WebP al momento del caricamento, puoi applicarla così com'è.
5️⃣ Perché meta charset è finito più in basso: Delay JS di WP Rocket
Anche dopo aver aggiunto charset all'intestazione di risposta, il meta charset dell'HTML in cache resta al byte 15.199. Nella pagina generata direttamente da PHP, la stessa riga era al byte 135.
Con Delay JS di WP Rocket attivo, quando viene creato il file di cache vengono inseriti subito dopo head script a esecuzione ritardata come lazyload, e poi un passaggio riporta il meta charset all'inizio di head. Questo passaggio applica un'espressione regolare all'intero documento, quindi su un articolo grande di circa 1,2 MB supera il limite di backtrack di PHP e fallisce.
Quando l'espressione regolare fallisce, WP Rocket mette in cache l'HTML così com'è, con gli script inseriti ma senza aver spostato il meta charset, e di conseguenza il meta charset è finito fuori dai primi 1.024 byte. In una riproduzione separata con le stesse impostazioni di PHP, lo spostamento è fallito con il limite di backtrack al valore predefinito di 1.000.000 e a 5.000.000, ed è riuscito da 10.000.000 in su.
Questa volta ho risolto aggiungendo charset all'intestazione di risposta e non ho corretto la posizione del meta charset. Alzare il limite di backtrack ripristina il comportamento originale di WP Rocket, ma decuplica il limite di tutte le espressioni regolari eseguite nello stesso PHP, quindi non lo consiglio.
🔢 FAQ & contenuti consigliati

 HTTP 404
Errore HTTP 404 (errore del client): cause e soluzione
La pagina di errore HTTP 404, uno dei codici di stato HTTP, compare quando una pagina non viene trovata.
 AdSense
Configurazione di ads.txt in WordPress: risolvere l'avviso di AdSense
ads.txt è un file di testo posto nella radice del sito che elenca pubblicamente i venditori autorizzati a vendere gli spazi pubblicitari del dominio.
 Cache di WP Rocket
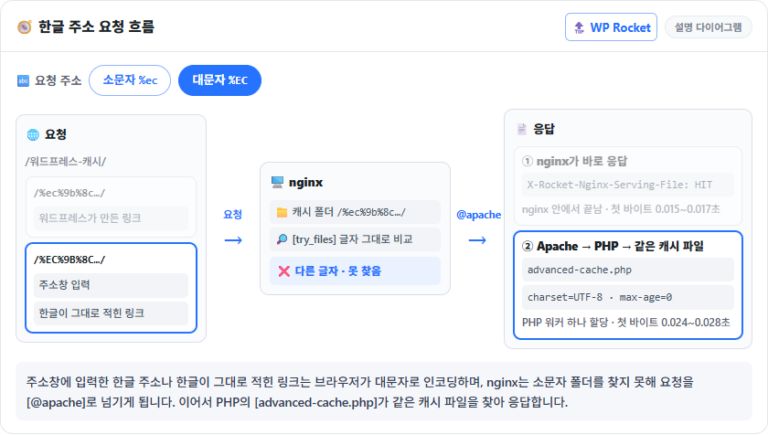
WP Rocket e URL in coreano: perché nginx non trova il file di cache e la soluzione con njs
Per gli articoli con slug in inglese nginx serve direttamente il file di cache, mentre per gli articoli con slug in coreano, anche se lo stesso file di cache esiste, viene servito solo dopo che PHP è stato eseguito una volta.
ℹ️ Informativa sull'affiliazione
I contenuti di questo sito includono link di affiliazione. Se un visitatore acquista un prodotto o un servizio tramite uno di questi link, il sito riceve una commissione dal venditore. In questo processo l'importo pagato dall'acquirente (durante le promozioni l'importo scende↓) non aumenta. Prezzi, sconti e disponibilità indicati si riferiscono al momento della stesura e possono differire da quelli reali: prima di acquistare verifica sempre presso il venditore. I prodotti vengono scelti e valutati secondo criteri propri, e le commissioni non influiscono sull'ordine di presentazione né sul contenuto delle valutazioni.