
meta charset utf-8: 404 durch koreanische Bildadressen, die der AdSense-Crawler zerbrochen hat, und ein voller php-fpm-Pool
Findet der Leser die Deklaration meta charset utf-8 nicht am Anfang des HTML und fehlt auch im Antwort-Header ein charset, muss er die Zeichenkodierung des Dokuments raten oder einen Standardwert nehmen. Auf einem WordPress-Server mit Nginx und Apache schickte der AdSense-Crawler gehäuft Anfragen an kaputte koreanische (Nicht-ASCII-)Bildadressen, und die 404-Verarbeitung belegte alle PHP-Worker. Nachdem ich das in den Logs verfolgt hatte, habe ich dem Antwort-Header der Cache-Seiten ein charset hinzugefügt und nginx fehlende statische Dateien direkt mit 404 beantworten lassen, damit dieselben Anfragen die Worker nicht wieder füllen.
1️⃣ meta charset utf-8: Warum es in den ersten 1.024 Bytes stehen muss
Der Server kann die Zeichenkodierung eines Dokuments an zwei Stellen angeben: im charset hinter dem Antwort-Header [Content-Type] und in der meta-charset-Zeile im HTML.
Der HTML-Standard schreibt vor, dass die Deklaration der Zeichenkodierung nur in den ersten 1.024 Bytes stehen darf, und empfiehlt dem Leser, nur diese ersten 1.024 Bytes vorab zu lesen und darin zu suchen. Deshalb übersehen manche Leser ein meta charset, das hinter 1.024 Bytes gerutscht ist, auch wenn es noch innerhalb von head steht.
Um die Kodierung festzulegen, prüft der Leser zuerst die BOM (Byte Order Mark), danach das charset im Antwort-Header und dann das meta charset, das beim Vorablesen der ersten 1.024 Bytes gefunden wird. Fehlen alle drei, rät er anhand der Bytes oder nutzt einen festgelegten Standardwert, und in der Standardwerttabelle, die der HTML-Standard vorschlägt, ist das für die meisten locale windows-1252.
Liest man ein UTF-8-Dokument als windows-1252, wird ein einzelnes Zeichen aus mehreren Bytes, etwa ein koreanischer Buchstabe, zu mehreren anderen Zeichen.
2️⃣ Koreanische (Nicht-ASCII-)Bildadressen, die der AdSense-Crawler Mediapartners-Google zerbrochen hat
Bei der Prüfung der Cache-Seite von vor der Korrektur nach dem Maßstab der ersten 1.024 Bytes hatte der Antwort-Header Content-Type kein charset, und die meta-charset-Zeile stand bei Byte 15.199. Die Cache-Seite, die der AdSense-Crawler Mediapartners-Google erhielt, hatte also an keiner der beiden Stellen eine auffindbare Kodierung.
curl -sI https://example.com/sample-post/ | grep -i '^content-type'content-type: text/htmlIn diesem Aufbau überspringt ein Query-String hinter der Adresse die Cache-Seite, und es kommt eine direkt von PHP erzeugte Antwort, die tatsächlich ein charset trug.
curl -sI 'https://example.com/sample-post/?nocache=1' | grep -i '^content-type'content-type: text/html; charset=UTF-8An welchem Byte das meta charset in der Cache-Datei beginnt, zeigt [grep -b] bytegenau an.
grep -bo '<meta charset' /var/www/html/wp-content/cache/wp-rocket/example.com/sample-post/index-https.html | head -115199:<meta charsetDie img-Tags in derselben Cache-Datei enthielten mehrsprachige UTF-8-Dateinamen (hier Koreanisch) unverändert, ohne Prozentkodierung. Wird dieses HTML als windows-1252 gelesen, wird aus einem Namen wie [대시보드-화면-예시.png] eine Zeichenfolge wie [대시보드-화면-예시.png], und wenn diese Zeichen wieder als UTF-8 prozentkodiert angefragt werden, sucht der Server eine Datei, die es nicht gibt.
Zieht man die Bild-404 dieses Crawlers aus dem Access-Log, folgen die Adressen mit kaputten Namen eine nach der anderen.
grep 'Mediapartners-Google' /var/log/nginx/access.log | grep ' 404 ' | grep 'GET /wp-content/uploads/' | cut -d' ' -f1,4,7,9 | head -2203.0.113.3 [03/Nov/2026:20:40:51 /wp-content/uploads/2025/07/---1024x682.png 404
203.0.113.1 [03/Nov/2026:20:40:51 /wp-content/uploads/2025/07/---300x159.jpg 404Die Adressen im Log stimmten Byte für Byte mit dem Wert überein, der entsteht, wenn man die UTF-8-Bytes des ursprünglichen Dateinamens als windows-1252-Zeichen liest und wieder als UTF-8 kodiert. Im Log dieses Tages kamen 202 Anfragen an so zerbrochene Bildadressen von diesem Crawler und 6 von einem einzelnen Skript (python-requests), von Besuchern kamen 0.
Wenn du den kaputten Namen [대시보드-화면-예시.png] mit dem UTF-8-Konverter zurückwandelst, wird er als UTF-8-Bytes erkannt, die als windows-1252 gelesen wurden, und der ursprüngliche Name [대시보드-화면-예시.png] erscheint.
3️⃣ Wie 404 für fehlende Bilder php-fpm füllten
Da die Bilder unter den kaputten Adressen auf dem Server nicht existieren, reichte nginx die Anfragen gemäß dem letzten Eintrag von try_files in seiner Bild-location an Apache weiter, und WordPress erzeugte die 404-Seite mit PHP. Bei den 587 404, die am selben Tag tagsüber protokolliert wurden, brauchte jede 404-Seite ohne Cache im Median 1,4 Sekunden.
Anfragen an Bilder mit kaputten Namen häuften sich in den 3 Minuten ab 20:40 auf gut 200, und 133 davon endeten mit 404. Jede Anfrage bekommt einen php-fpm-Worker, und weil weiter Anfragen kamen, während jede 404 4 bis 6 Sekunden dauerte, erreichte der Pool um 20:40:55 seine Obergrenze.
Der Moment, in dem der Pool seine Obergrenze erreicht, steht im Fehlerprotokoll von php-fpm als php-fpm max_children-Warnung.
grep 'max_children' /var/log/php-fpm/error.log[03-Nov-2026 20:40:55] WARNING: [pool www] server reached pm.max_children setting (20), consider raising itAnfragen, die nach dem Volllaufen des Pools kamen, warteten auf einen freien Worker. Die am längsten wartende 404 war nach 58 Sekunden fertig, Anfragen, die der Crawler nach 60 Sekunden Warten abbrach, wurden als 499 protokolliert, und eine Anfrage ohne Antwort vom Backend als 504.
Das Vorladen des Caches, die geplanten Aufgaben (Action Scheduler), die zur selben Zeit liefen, und wp-cron, das jede Minute läuft, habe ich geprüft und als Ursache ausgeschlossen. Das Vorladen lief den ganzen Tag mit derselben niedrigen Rate, die geplanten Aufgaben verarbeiteten zu der Zeit nur Vorlade-Jobs, und wp-cron läuft mit Kommandozeilen-PHP und nutzt keine php-fpm-Worker.
4️⃣ nginx charset utf-8 und sofortiges 404 für fehlende statische Dateien
Ich habe der nginx-location, die die Cache-Seiten ausliefert, die eine Zeile [charset utf-8;] hinzugefügt, damit der Antwort-Header ein charset trägt, und für Bilder und statische Dateien im Upload-Ordner gibt nginx jetzt direkt 404 zurück, wenn sie nicht auf der Festplatte liegen, statt sie an WordPress weiterzureichen.
# http-Block: Cache-Control-Wert nur für 404-Antworten festlegen
map $status $up404_cc { 404 'no-store'; default ''; }

# location, die das Cache-HTML direkt ausliefert
location / {
    try_files $cache_file @backend;
    charset utf-8;
}

# Upload-Ordner: fehlende Bilder bekommen direkt 404, ohne Umweg über das Backend
location ~* ^/wp-content/uploads/.+[.](jpg|jpeg|png)$ {
    try_files $uri =404;
    add_header Cache-Control $up404_cc always;
}
Die map gehört in den http-Block, und weil nginx einen Header mit leerem Wert gar nicht sendet, bekommen 200-Antworten kein no-store. Regex-locations werden von oben geprüft, und die erste passende gilt, deshalb habe ich sie vor die bestehende Bild-location gesetzt und für statische Dateien wie css, js und Schriften eine weitere location derselben Art ergänzt.
Nach der Korrektur trug der Antwort-Header der Cache-Seite bei derselben Adresse ein charset.
curl -sI https://example.com/sample-post/ | grep -i '^content-type'content-type: text/html; charset=utf-8curl -sI https://example.com/wp-content/uploads/2025/07/no-such-image.png | grep -i -E '^(HTTP|content-type|cache-control)'# Vor der Korrektur: eine von WordPress erzeugte 404
HTTP/2 404
content-type: text/html; charset=UTF-8
cache-control: no-cache, must-revalidate, max-age=0, no-store, private
# Nach der Korrektur: eine direkt von nginx zurückgegebene 404
HTTP/2 404
content-type: text/html
cache-control: no-storeDie 404 für ein fehlendes Bild wechselte von einer WordPress-Seite, die 319.058 Bytes in 1,01 Sekunden erzeugte, zur Standardseite von nginx mit 555 Bytes in 0,015 Sekunden. Weil [Cache-Control: no-store] nur an 404 hängt, speichert das CDN keine 404 für fehlende Bilder. An Antworten, die PHP schon mit charset geschickt hat, hängt nginx kein zweites charset an, deshalb stand es nur einmal im Antwort-Header.
| Geprüfte Anfrage | Vor der Korrektur | Nach der Korrektur |
|---|---|---|
| Fehlendes Bild | 319.058 B, 1,01 Sekunden (WordPress-404) | 555 B, 0,015 Sekunden (nginx-404) |
| Bild mit kaputtem Namen | 1,05 Sekunden (WordPress-404) | 0,014 Sekunden (nginx-404) |
| Antwort-Header des Cache-HTML | text/html | text/html; charset=utf-8 |
| Antwort-Header direkt von PHP erzeugt | text/html; charset=UTF-8 | Gleich (charset einmal) |
| Vorhandenes Bild | 200 | Weiter 200 |
Für Websites mit Bild-Plugins, die Vorschaubilder oder WebP erst nach einer Anfrage mit PHP erzeugen, passt diese 404-Behandlung nicht. Weil nginx zuerst 404 zurückgibt, wird das Bild nie erzeugt. Wenn dein Aufbau WebP schon beim Hochladen als Datei anlegt, kannst du sie unverändert übernehmen.
5️⃣ Warum meta charset nach hinten rutschte: WP Rocket Delay JS
Auch nach dem charset im Antwort-Header steht das meta charset im Cache-HTML weiterhin bei Byte 15.199. In der direkt von PHP erzeugten Seite stand dieselbe Zeile bei Byte 135.
Ist Delay JS von WP Rocket eingeschaltet, fügt es beim Erstellen der Cache-Datei direkt nach head verzögerte Skripte wie lazyload ein und verschiebt danach in einem eigenen Schritt das meta charset wieder an den Anfang von head. Dieser Schritt wendet eine Regex auf das ganze Dokument an, daher überschreitet er bei einem großen Beitrag von etwa 1,2 MB das backtrack-Limit von PHP und scheitert.
Scheitert die Regex, cacht WP Rocket das HTML so, wie es ist, mit eingefügten Skripten, aber ohne verschobenes meta charset, und dadurch rutschte das meta charset aus den ersten 1.024 Bytes heraus. In einer separaten Nachstellung mit denselben PHP-Einstellungen scheiterte das Verschieben beim backtrack-Limit auf dem Standardwert 1.000.000 und auf 5.000.000 und gelang ab 10.000.000.
Diesmal habe ich das Problem mit dem charset im Antwort-Header gelöst und die Position des meta charset nicht korrigiert. Ein höheres backtrack-Limit bringt das ursprüngliche Verhalten von WP Rocket zurück, verzehnfacht aber das Limit für jede Regex im selben PHP, deshalb empfehle ich es nicht.
🔢 FAQ & empfohlene Inhalte

 HTTP 404
HTTP-404-Fehler (Client-Fehler): Ursachen und Lösung
Die Fehlerseite HTTP 404, einer der HTTP-Statuscodes, erscheint, wenn eine Seite nicht gefunden wird.
 AdSense
ads.txt in WordPress einrichten: AdSense-Warnung beheben
ads.txt ist eine Textdatei im Stammverzeichnis der Website, die öffentlich auflistet, welche autorisierten Verkäufer die Werbeflächen dieser Domain verkaufen dürfen.
 WP Rocket-Cache
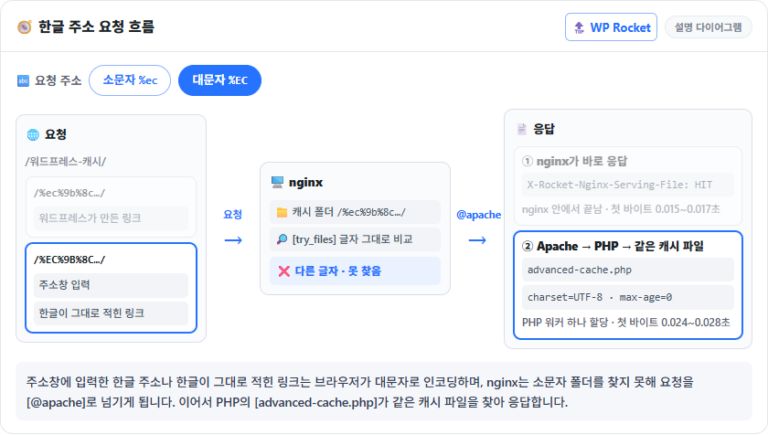
WP Rocket mit koreanischen URLs: Warum nginx die Cache-Datei nicht findet und die Lösung mit njs
Bei Beiträgen mit englischem Slug liefert nginx die Cache-Datei direkt aus, bei Beiträgen mit koreanischem Slug dagegen erst, nachdem PHP einmal gelaufen ist, auch wenn dieselbe Cache-Datei vorhanden ist.
ℹ️ Affiliate-Hinweis
Die Inhalte dieser Website enthalten Affiliate-Links. Kauft ein Besucher über einen dieser Links ein Produkt oder eine Dienstleistung, erhält die Website vom Verkäufer eine Provision. Der Betrag, den der Käufer zahlt(bei Aktionsrabatten sinkt er ↓), steigt dadurch nicht. Angegebene Preise, Rabatte und Lagerbestände entsprechen dem Stand bei Erstellung und können abweichen; prüfe sie daher vor dem Kauf beim Verkäufer. Produkte werden nach eigenen Kriterien ausgewählt und bewertet, und Provisionen beeinflussen weder die Reihenfolge noch den Inhalt der Bewertungen.